On-Demand Lifecycle (Scale-to-Zero)
Adapter, die nur gelegentlich genutzt werden — zum Beispiel ein Adapter, der auf Anfrage Dokumente erzeugt, oder einer, der einmal pro Nacht Daten importiert — müssen nicht rund um die Uhr laufen. Mit dem On-Demand-Lifecycle skaliert OctoMesh einen solchen Adapter nach einer Phase der Inaktivität auf null Replicas herunter und weckt ihn automatisch auf, sobald er wieder benötigt wird. Adapter, die Live-Datenströme verarbeiten, laufen dauerhaft weiter.
Die Funktion gilt für Adapter, die über einen Deployment Site bereitgestellt werden (Helm-verwaltete Workloads).
Lifecycle-Modi
Jeder pool-verwaltete Adapter hat einen LifecycleMode:
| Modus | Verhalten |
|---|---|
AlwaysOn (Standard) | Der Adapter läuft dauerhaft. Gegenüber früheren OctoMesh-Versionen ändert sich nichts. |
OnDemand | Der Adapter wird auf null Replicas skaliert, nachdem er länger als IdleTimeoutMinutes (Standard 30) untätig war, und wird bei Bedarf automatisch geweckt. |
Die Einstellung IdleTimeoutMinutes legt fest, wie lange der Adapter untätig sein darf — keine Pipeline-Ausführung — bevor er schlafen gelegt wird.
Ein dritter Modus, Auto, ist im Datenmodell für eine zukünftige Version reserviert, in der OctoMesh den Modus aus den Pipeline-Triggern des Adapters ableitet. Er ist noch nicht funktionsfähig und wird von der Plattform abgelehnt — verwenden Sie AlwaysOn oder OnDemand.
Lifecycle-Zustände
Die aktuelle Lifecycle-Situation eines Adapters wird im Runtime-Feld LifecycleState angezeigt:
| Zustand | Bedeutung |
|---|---|
Running | Der Adapter läuft und verarbeitet Arbeit wie gewohnt. |
Draining | Der Idle-Timeout ist abgelaufen; die Plattform skaliert den Adapter auf null Replicas herunter. |
Hibernated | Der Adapter ist auf null skaliert. Er verbraucht keine Cluster-Ressourcen; sein Helm-Release und seine Konfiguration bleiben erhalten. |
Waking | Ein Bedarfssignal ist eingetroffen; der Adapter wird wieder hochskaliert. Der Zustand kehrt zu Running zurück, sobald der Adapter sich neu registriert hat und seine Pipeline-Konfiguration angewendet ist. |
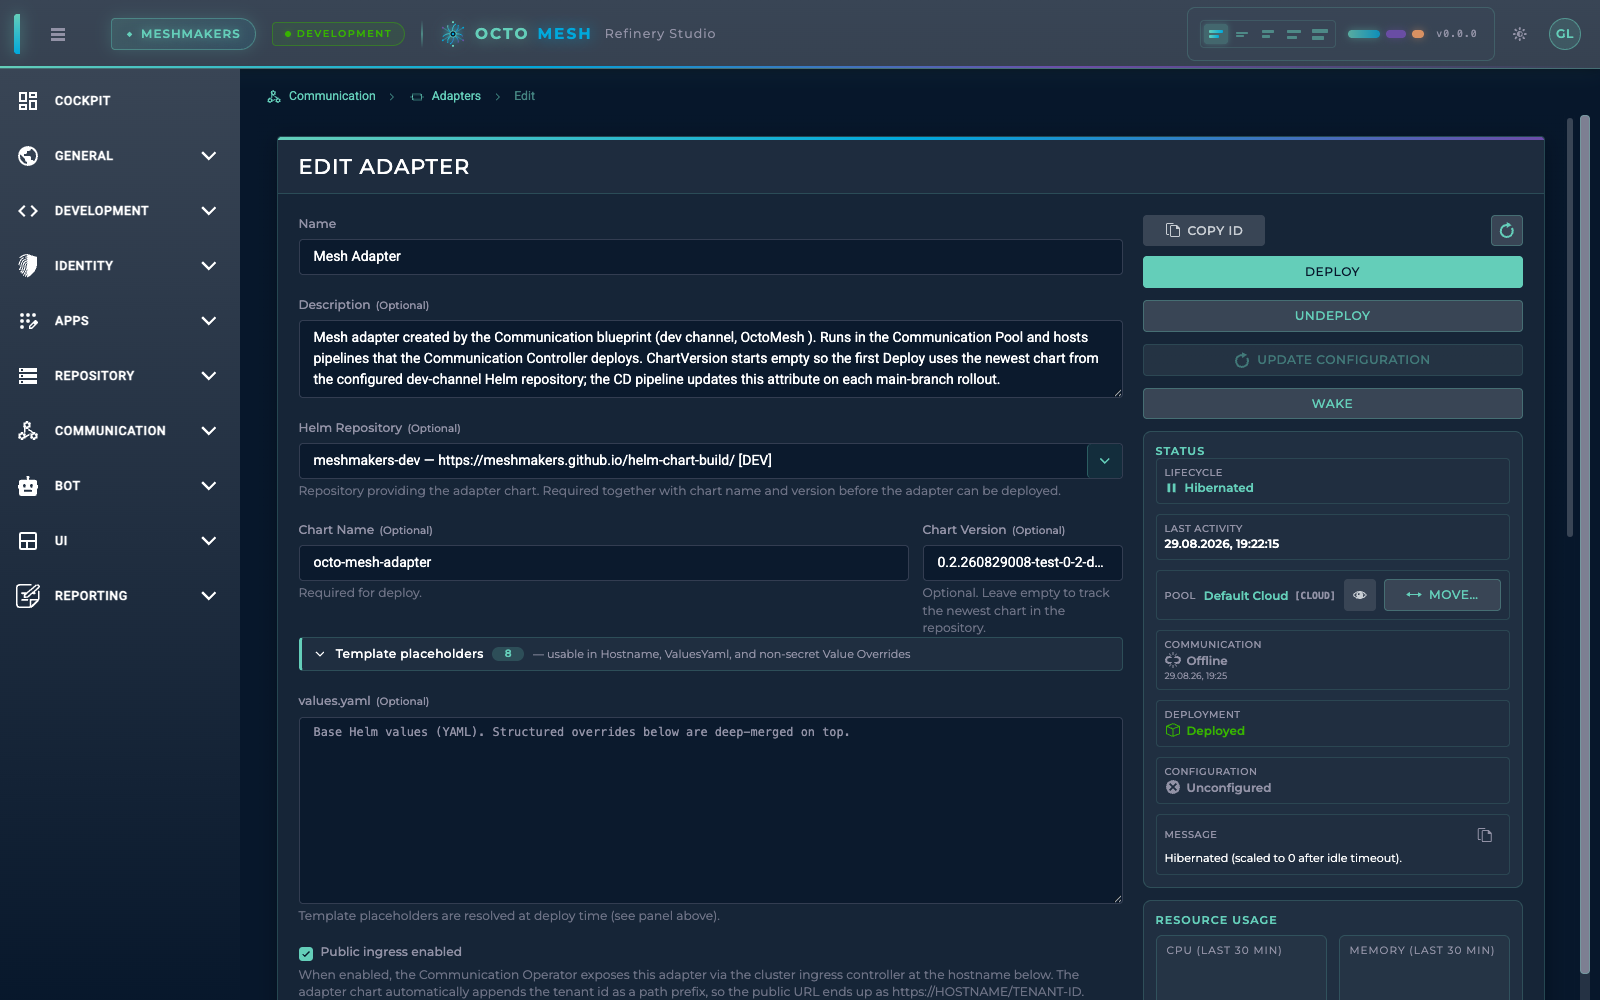
Während ein Adapter im Ruhezustand ist, bleibt DeploymentState auf Deployed (das Helm-Release existiert weiterhin) und CommunicationState zeigt Offline — der Adapter-Prozess läuft absichtlich nicht, sodass ein Offline-Kommunikationszustand in dieser Situation normal und erwartet ist, kein Ausfall. Lesen Sie diese beiden Felder stets zusammen mit LifecycleState.
Scale-to-Zero aktivieren
Zwei Schalter müssen beide aktiviert sein, bevor ein Adapter herunterskaliert:
-
Pro Tenant — Scale-to-Zero muss für den Tenant aktiviert sein. Dies ist Runtime-Konfiguration; ein Neu-Deployment eines Dienstes ist nicht erforderlich:
# enable for the current tenantocto-cli -c SetCommunicationLifecycle -sze true# check the current settingocto-cli -c GetCommunicationLifecycle-sze falsewieder zu setzen ist der Not-Aus pro Tenant: Es werden keine weiteren Adapter mehr in den Ruhezustand versetzt, und bereits ruhende Adapter kommen beim nächsten Bedarfssignal (oder über ein manuelles Wecken) zurück. -
Pro Adapter — setzen Sie
LifecycleModeaufOnDemandund wählen Sie einIdleTimeoutMinutesin der Edit-Ansicht des Adapters in Refinery Studio (oder über GraphQL). Der Standardmodus istAlwaysOn, sodass nur Adapter teilnehmen, die Sie explizit dafür anmelden.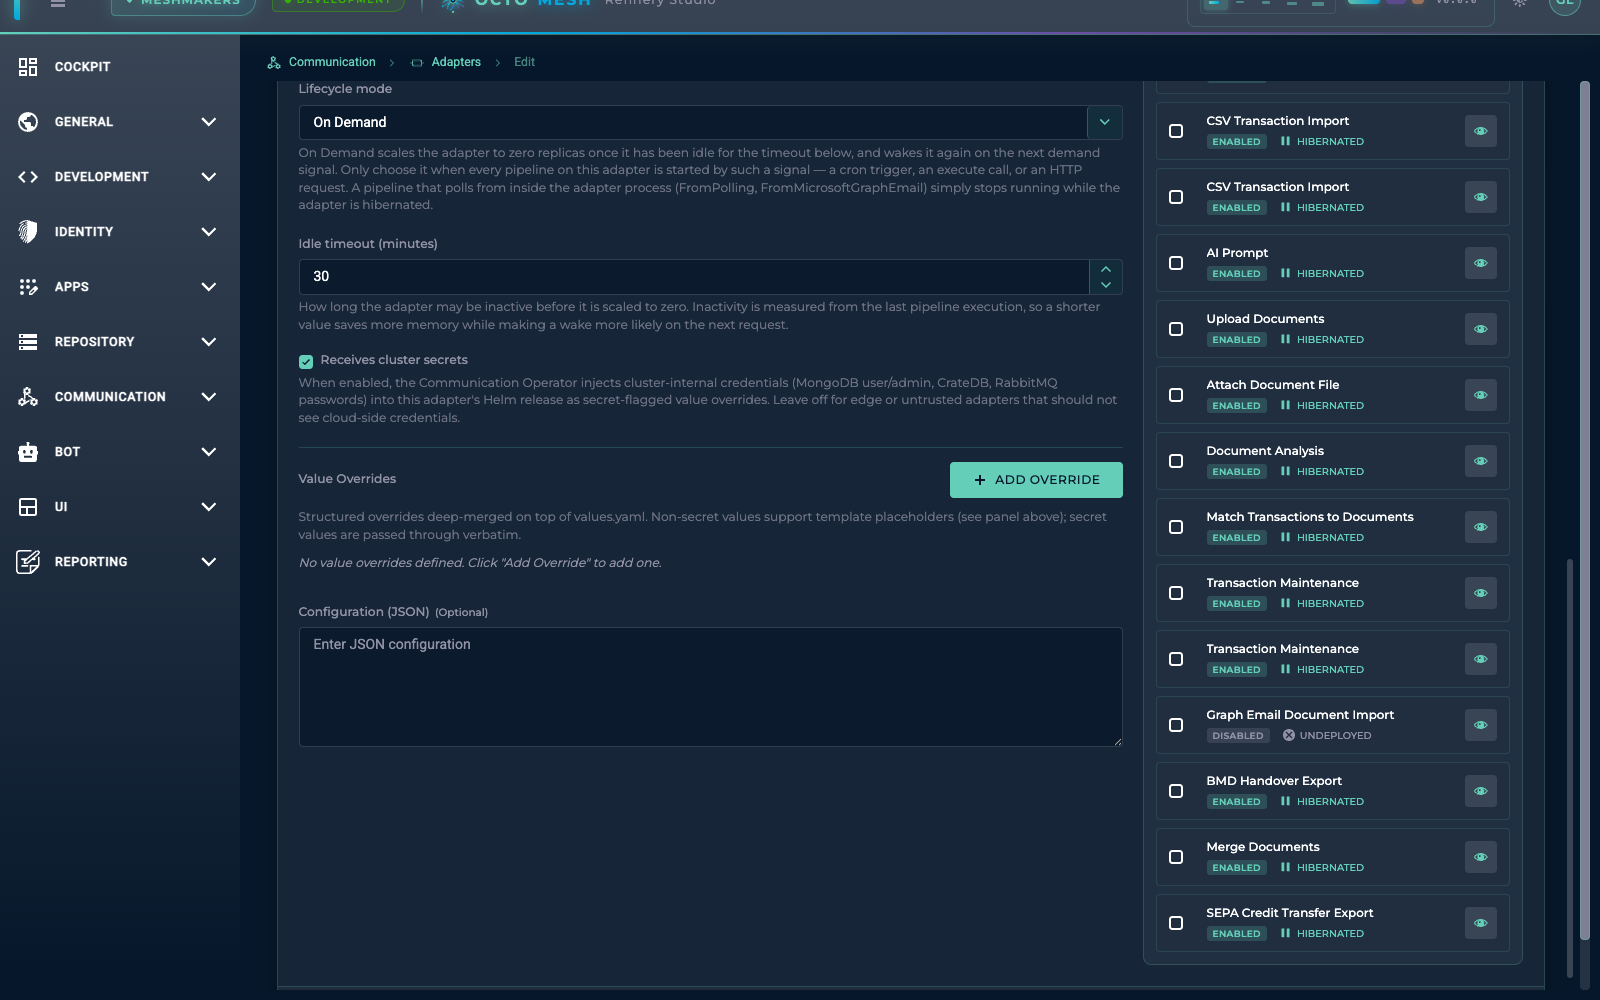
LifecycleMode und IdleTimeoutMinutes sind Teil der verfassten Konfiguration des Adapters. Wenn die Adapter-Entität von einem Blueprint verwaltet wird, setzt ein erneutes Anwenden des Blueprints diese Felder auf die vom Blueprint geseedeten Werte zurück. Setzen Sie den Modus entweder in den Seed-Daten des Blueprints oder prüfen Sie die Adapter-Einstellungen nach einem Blueprint-Update erneut.
Wie der Ruhezustand funktioniert
Ein Hintergrund-Watchdog in der Plattform prüft On-Demand-Adapter periodisch (standardmäßig alle 5 Minuten). Ein Adapter gilt als untätig, wenn länger als sein IdleTimeoutMinutes keine Pipeline-Ausführung stattgefunden hat. Ein Adapter wird niemals schlafen gelegt, während:
- gerade eine Pipeline-Ausführung läuft oder
- ein Konfigurations-Deployment im Gange ist.
Wenn der Adapter untätig ist, skaliert die Plattform sein Deployment auf null Replicas (Draining → Hibernated). Die Pipelines des Adapters erscheinen als Pending, während er im Ruhezustand ist — dies vermerkt lediglich, dass ihre Konfiguration beim nächsten Aufwecken erneut ausgeliefert wird.
Wie das Aufwecken funktioniert
Jedes der folgenden Signale weckt einen ruhenden Adapter:
- Eine Pipeline-Ausführungsanforderung — das Ausführen einer Pipeline auf einem ruhenden Adapter weckt ihn transparent zuerst auf und führt dann die Pipeline aus.
- Der Wake-Button in Refinery Studio — verfügbar im Kontextmenü der Adapterliste und in der Edit-Ansicht des Adapters. Die Aktion blockiert, bis der Adapter bereit ist (bis zum Wake-Budget von 60 Sekunden), und zeigt während des Aufweckens den Fortschritt an.
- Die REST-API —
POST {tenantId}/v1/adapter/{workloadRtId}/wakeauf dem Communication-Dienst. Anwendungen können dies aufrufen, um einen Adapter vor dem Senden von Arbeit vorzuwärmen. - Eine eingehende HTTP-Anfrage — wenn der HTTP-Aktivator konfiguriert ist, weckt eine Anfrage an einen der HTTP-Endpunkte des Adapters ihn automatisch.
- Ein geplanter (Cron-)Trigger — Pipeline-Trigger wecken den Adapter zu ihrer geplanten Zeit auf; siehe den nächsten Abschnitt.
Geplante Trigger und Event-Nachrichten gehen während des Ruhezustands nicht verloren: Trigger- und Data-Event-Nachrichten puffern in dauerhaften Queues und werden verarbeitet, sobald der Adapter wieder oben ist.
Das Aufwecken selbst ist abgeschlossen, wenn der Adapter sich neu registriert hat und seine Konfiguration als angewendet meldet. Rechnen Sie mit einer ersten Antwortzeit von etwa 8 Sekunden nach einem Wake; Anfragen, die über den HTTP-Aktivator eintreffen, können einige Sekunden länger dauern, weil der HTTP-Endpunkt des Adapters zusätzlich seinen Readiness-Probe bestehen muss.
Ein ruhender Adapter in der Edit-Ansicht — Deployed plus Offline ist die erwartete Kombination, das Statuspanel benennt den Lifecycle-Zustand, und der Wake-Button startet ihn bei Bedarf:
HTTP-Aktivator: Aufwecken bei HTTP-Anfragen
Adapter können über Pipelines mit HTTP-Triggern HTTP-Endpunkte bereitstellen. Bei auf null skaliertem Workload würde der Cluster-Ingress eine solche Anfrage normalerweise mit einem Fehler beantworten. Der HTTP-Aktivator schließt diese Lücke: Die erste Anfrage an einen ruhenden Adapter wird von der Plattform gehalten, der Adapter wird geweckt, und die Anfrage wird dann ausgeliefert — der Aufrufer erlebt lediglich eine langsamere erste Antwort.
Der Aktivator ist standardmäßig deaktiviert und wird vom Cluster-Operator eingerichtet:
-
Aktivieren Sie den Aktivator im OctoMesh Helm-Chart:
services.communication.activatorEnabled: true. -
Leiten Sie Traffic zu ihm, indem Sie zwei Annotations auf die Workload-Ingresses projizieren, über die clusterweiten Ingress-Annotations der Communication Operator (
operator.ingress.annotationsim Operator-Chart):nginx.ingress.kubernetes.io/default-backend, das den Communication-Dienst benennt — NGINX routet dann genau dann zum Aktivator, wenn der Adapter-Dienst keinen bereiten Endpunkt hat.nginx.ingress.kubernetes.io/proxy-read-timeout, gesetzt auf mindestens das Wake-Budget (60 Sekunden) — andernfalls kann der Ingress-Standard von 60 Sekunden die gehaltene Anfrage abschneiden.
Das Aktivieren des Chart-Flags ohne die Annotations hat keine Wirkung, und umgekehrt.
Verhalten:
- Die Anfrage wird gehalten, während der Adapter aufwacht, und dann weitergeleitet. Request-Bodies bis 32 MB werden gepuffert und sicher erneut ausgeliefert, sodass Uploads das Aufwecken überstehen.
- Wird der Adapter nicht innerhalb des Wake-Budgets bereit, erhält der Aufrufer
503 Service Unavailablemit einemRetry-After-Header — ein erneuter Versuch nach diesem Intervall gelingt, sobald der Adapter oben ist. - Der Aktivator springt nur ein, wenn der Adapter nicht erreichbar ist; Steady-State-Traffic geht wie zuvor direkt an den Adapter.
Einschränkungen
Pipelines, deren Trigger innerhalb des Adapter-Prozesses laufen — zum Beispiel FromPolling oder FromMicrosoftGraphEmail — hören bei null Replicas auf zu funktionieren: Es gibt kein externes Signal, das den Adapter wecken könnte, sodass ihre Hintergrundarbeit stillschweigend stoppt. Setzen Sie LifecycleMode=OnDemand nicht auf Adaptern, die solche Pipelines beherbergen. Migrieren Sie diese Pipelines zuerst auf geplante Pipeline-Trigger, oder belassen Sie den Adapter auf AlwaysOn. Eine Validierung, die den On-Demand-Modus für solche Adapter ablehnt, ist geplant.
Mit On-Demand-Adaptern sicher:
- Geplante (Cron-)Trigger — der Zeitplan feuert in der Plattform, weckt den Adapter, und die Trigger-Nachricht wird aus einer dauerhaften Queue ausgeliefert.
- Queue-basierte Pipelines (Execute-Commands, Pipeline-Data-Events) — Nachrichten puffern dauerhaft während des Ruhezustands und werden nach dem Aufwecken verarbeitet.
- HTTP-getriggerte Pipelines — mit konfiguriertem HTTP-Aktivator, oder indem der Adapter zuerst über die Wake-API geweckt wird.
Bedenken Sie, dass jedes Aufwecken der ersten Anfrage Latenz hinzufügt (etwa 8 Sekunden). Für Adapter, die jederzeit sofort antworten müssen, belassen Sie AlwaysOn.
Pipeline-Debugging und Ruhezustand
Der Debug-Modus erhält keine besondere Lifecycle-Behandlung — das Zusammenspiel ergibt sich aus den Idle-Regeln:
- Eine aktive Debug-Sitzung hält den Adapter wach. Eine an einem Breakpoint pausierte Pipeline-Ausführung zählt weiterhin als laufende Ausführung, und laufende Ausführungen blockieren den Ruhezustand. Die Kehrseite: Ein vergessener Breakpoint hält den Adapter — und seine Debug-Capture-Puffer — unbegrenzt oben und macht die Scale-to-Zero-Ersparnis zunichte.
- Bewaffnetes Debugging verhindert den Ruhezustand nicht. Eine Pipeline mit aktiviertem Debugging, aber ohne laufende Ausführung, ist untätig wie jede andere; der Adapter geht normal in den Ruhezustand. Beim nächsten Aufwecken re-bewaffnet die Konfigurations-Neuauslieferung den Debug-Modus, sodass Breakpoints für neue Ausführungen wieder scharf sind — aber alles, was nur im Speicher des Adapters gehalten wird, übersteht das Herunterskalieren nicht: erfasste Node-Daten, die Sie noch nicht abgeholt haben, sind weg, und eine offene Debug-Sitzung in Refinery Studio verliert ihre Verbindung.
Für fokussierte Debugging-Arbeit belassen Sie den Adapter auf AlwaysOn oder erhöhen Sie für die Dauer seinen Idle-Timeout, und beenden (oder trennen) Sie Debug-Sitzungen, bevor Sie den Adapter wieder schlafen lassen.
Observability
Refinery Studio zeigt den Lifecycle-Zustand überall dort, wo der Adapter erscheint:
- die Adapterliste und die Adapter-Edit-Ansicht zeigen
Hibernated,DrainingundWakingexplizit (ein gesunderRunning-Adapter zeigt kein zusätzliches Icon), zusammen mit dem Zeitstempel der letzten Aktivität für On-Demand-Adapter; - die DataFlow-Liste markiert Datenflüsse eines ruhenden Adapters mit einem Pause-Icon — dass ihre Pipelines während des Ruhezustands
Pendingzeigen, ist die normale Neuauslieferungs-Buchführung, kein Fehler.
Für Monitoring und Alerting emittiert die Plattform Metriken und Events:
| Signal | Bedeutung |
|---|---|
octo.workload.wake.count | Anzahl der Wakes, getaggt mit dem Ergebnis (configured / timeout). |
octo.workload.wake.duration | Zeit von der Wake-Anforderung bis der Adapter konfiguriert und bereit war. |
octo.workload.hibernation.count | Anzahl der abgeschlossenen Ruhezustände. |
octo.workload.hibernated | Gauge: 1 während der Adapter im Ruhezustand ist oder drainiert, 0 während er läuft. |
octo.workload.offline_unexpected (Event) | Der Adapter ging offline, ohne dass der Lifecycle es erklärt — dies ist das Signal, auf das alarmiert werden sollte. Ein ruhender Adapter löst es nie aus. |